

Вебинар 11 ноября
Три расследования на примерах, близких к реальным: взаимоблокировка, нагрузка на процессор и падение рабочего процесса. Пошагово показываем, как система собирает данные для поиска первопричин.
Растёт нагрузка на сервер, вызов 1С выполняется слишком долго или возникает взаимоблокировка. Причины у этих проблем разные, но расследование часто начинается одинаково: нужно проверить метрики инфраструктуры, изучить технологический журнал (ТЖ) 1С, сопоставить процессы и сеансы кластера, разобраться в выполнении прикладного кода.
Самая трудоёмкая часть – сопоставить данные: установить, какие события совпали по времени и какие объекты с ними связаны. В «Умном мониторинге» для этого используется RCA (Root Cause Analysis), механизм анализа первопричин. В версии 1.6 мы расширили набор доступных метрик и добавили настраиваемые сценарии расследования, в первую очередь – для экосистемы 1С.
Алерт показывает симптом. RCA помогает найти причину
Алерт срабатывает по заданному условию: загрузка процессора превысила порог, ТЖ зафиксировал взаимоблокировку или система обнаружила дамп аварийно завершившегося процесса. Но сам сигнал не объясняет причину: какой вызов загрузил процессор, какие сеансы столкнулись и почему завершился процесс.
После регистрации инцидента RCA сопоставляет события и метрики, учитывая связи между конфигурационными единицами (КЕ), то есть объектами мониторинга: серверами, СУБД и её базами, компонентами кластера 1С и информационными базами. Если собранные данные позволяют, расследование доходит до конкретного вызова или строки прикладного кода 1С.
Ход расследования отображается на вкладке «Логи анализа RCA» в карточке результата. Там видно, какие данные использовала система, какие варианты проверила и на чём основан вывод. Специалист может проследить логику анализа и проверить результат.
Ниже – три расследования на демонстрационном стенде в ночь на 5 октября. Номера меток на рисунках соответствуют пояснениям в подписях: синие показывают, что выбрать или настроить, бирюзовые – на какие данные обратить внимание.
Пример 1. Взаимоблокировка: от события ТЖ до строки кода
Что случилось
В 01:14 два сеанса базы erp_main оказались во взаимоблокировке. Менеджер блокировок отменил одну из транзакций, и пользователь получил ошибку «Неустранимый конфликт блокировок».
Шаг 1. Правило
В разделе «Реагирование → Настройка уведомлений» включено поставочное правило «Взаимоблокировка». Оно отслеживает событие TDEADLOCK в технологическом журнале, создаёт инцидент и запускает RCA.
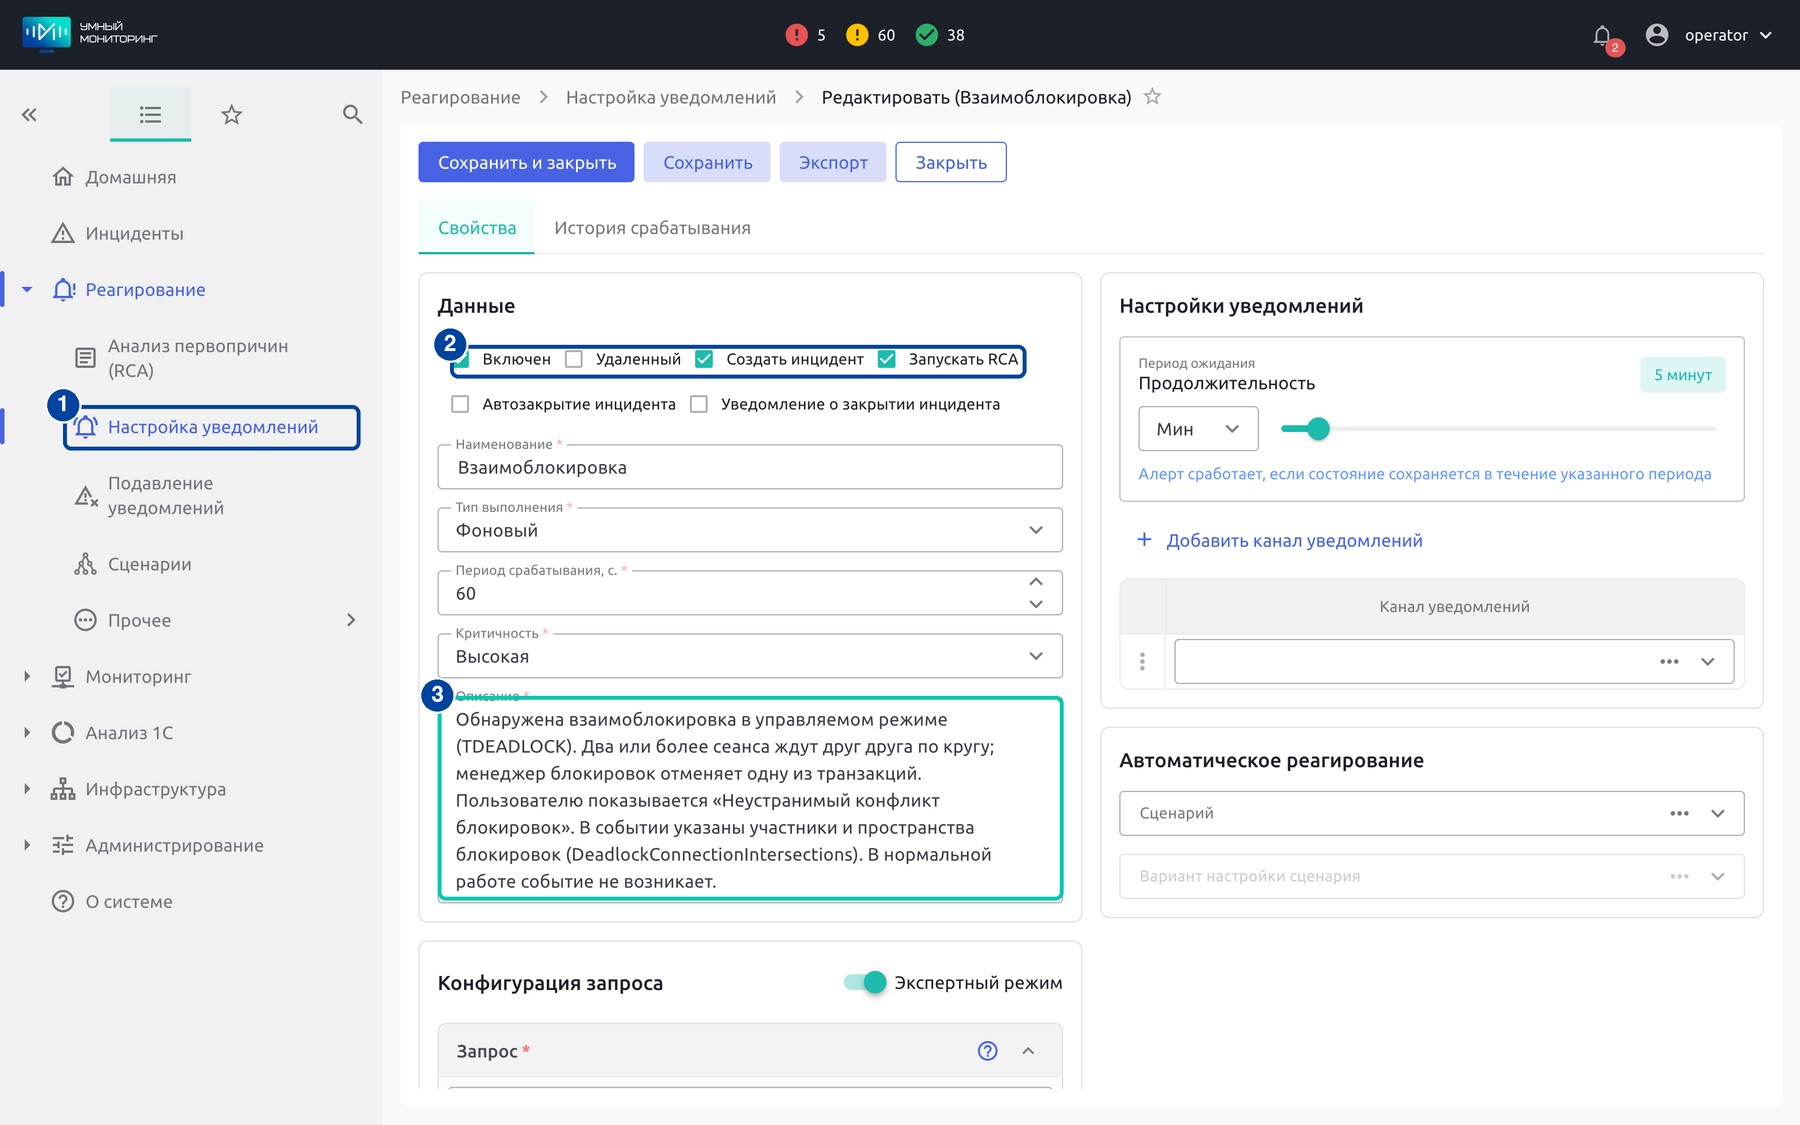
Рис. 1. Правило уведомления о взаимоблокировке. ①
Реагирование → Настройка уведомлений. ② Создать инцидент и запускать RCA. ③ Условие: событие TDEADLOCK в ТЖ.
Шаг 2. Результат RCA
В 01:17 зарегистрирован инцидент. Через 12 секунд RCA сформировал результат: инцидент связан со службой сервера 1С, а в поле «Первопричина» указана информационная база erp_main. В блоке ИИ-рекомендаций система описывает конфликт и предлагает дальнейшие действия.
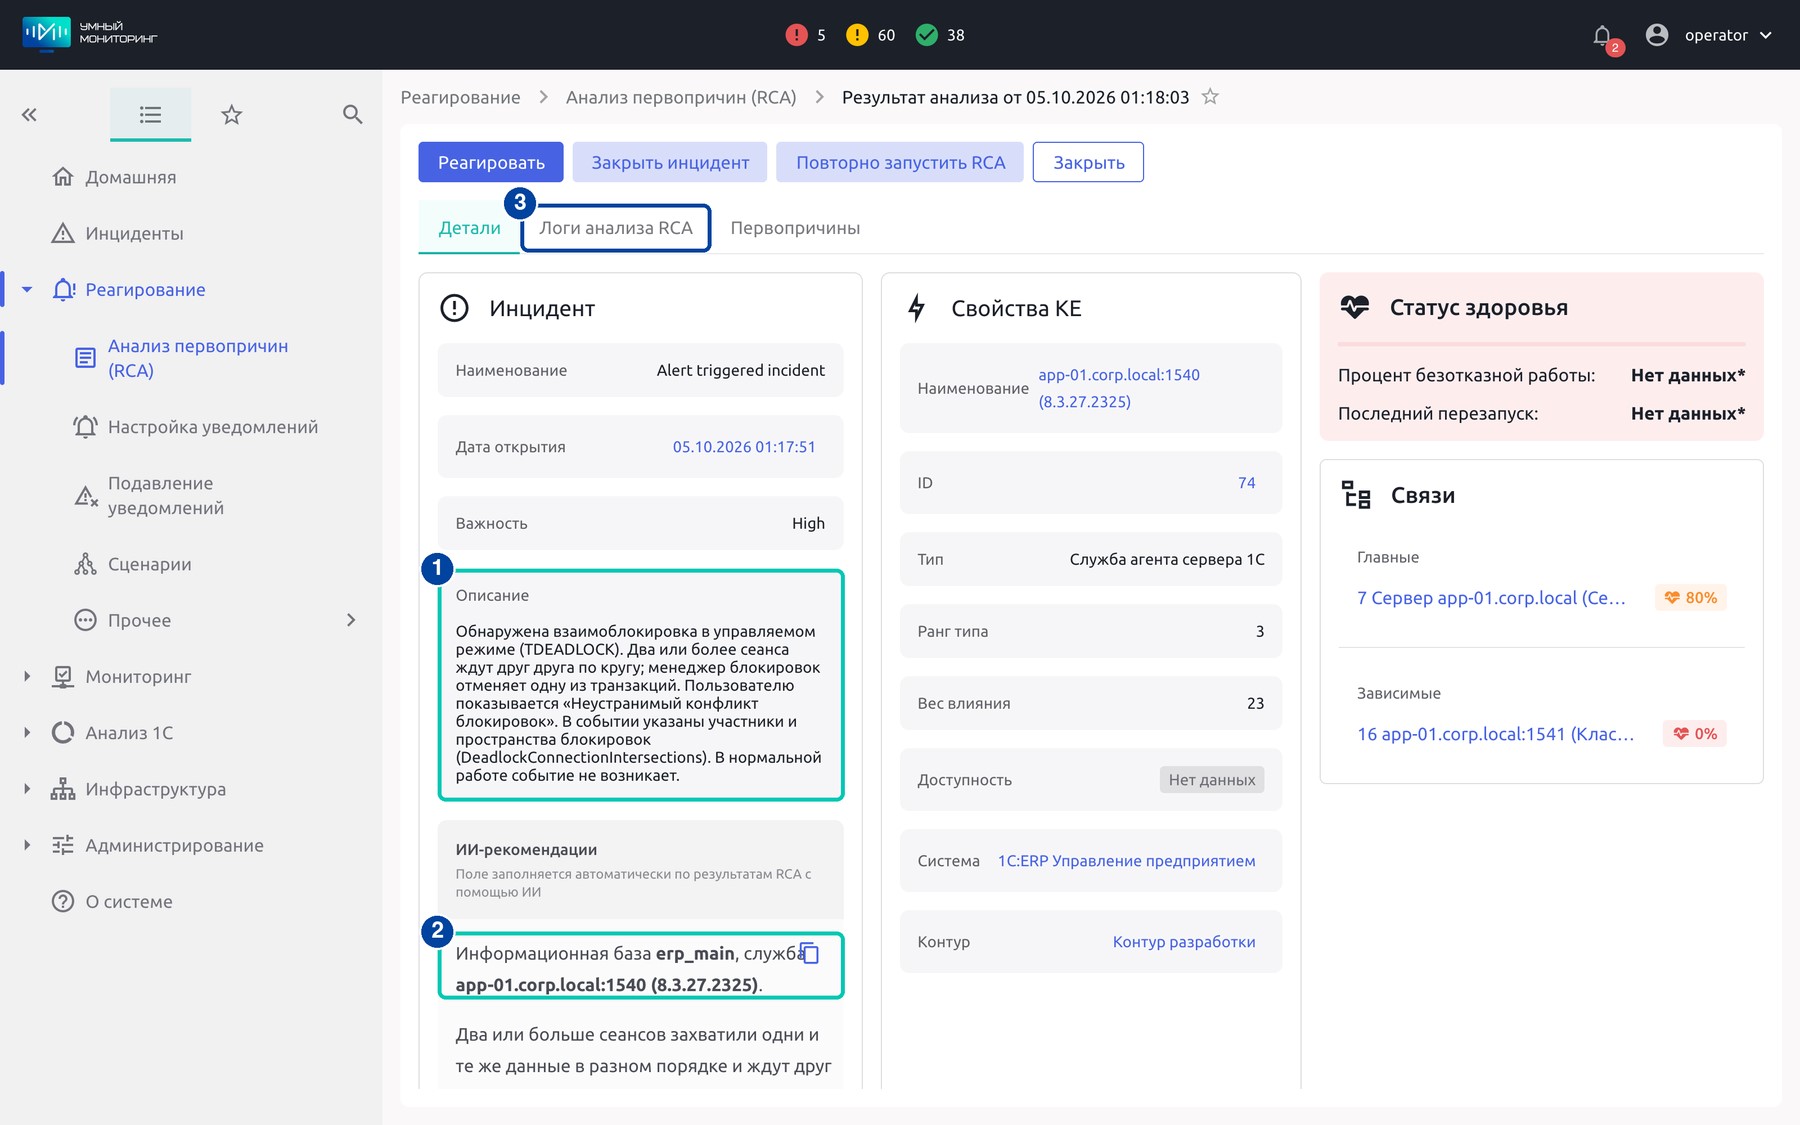
Рис. 2. Карточка результата RCA. ①
Инцидент: взаимоблокировка, 01:17. ② Первопричина: база erp_main. ③ Вкладка «Логи анализа RCA».
Шаг 3. Логи анализа
Система выбрала метрику блокировок за период инцидента, нашла событие TDEADLOCK и сопоставила участников по соединениям. Для каждого указаны сеанс, время захвата, строка кода, область и режим блокировки. Соединение 40862 (виновник) захватило регистр InfoRg53379 в строке 69 модуля расширения, а соединение 40863 (жертва) – регистр InfoRg53364 в строке 107. Оба сеанса ожидали ресурсы друг друга.
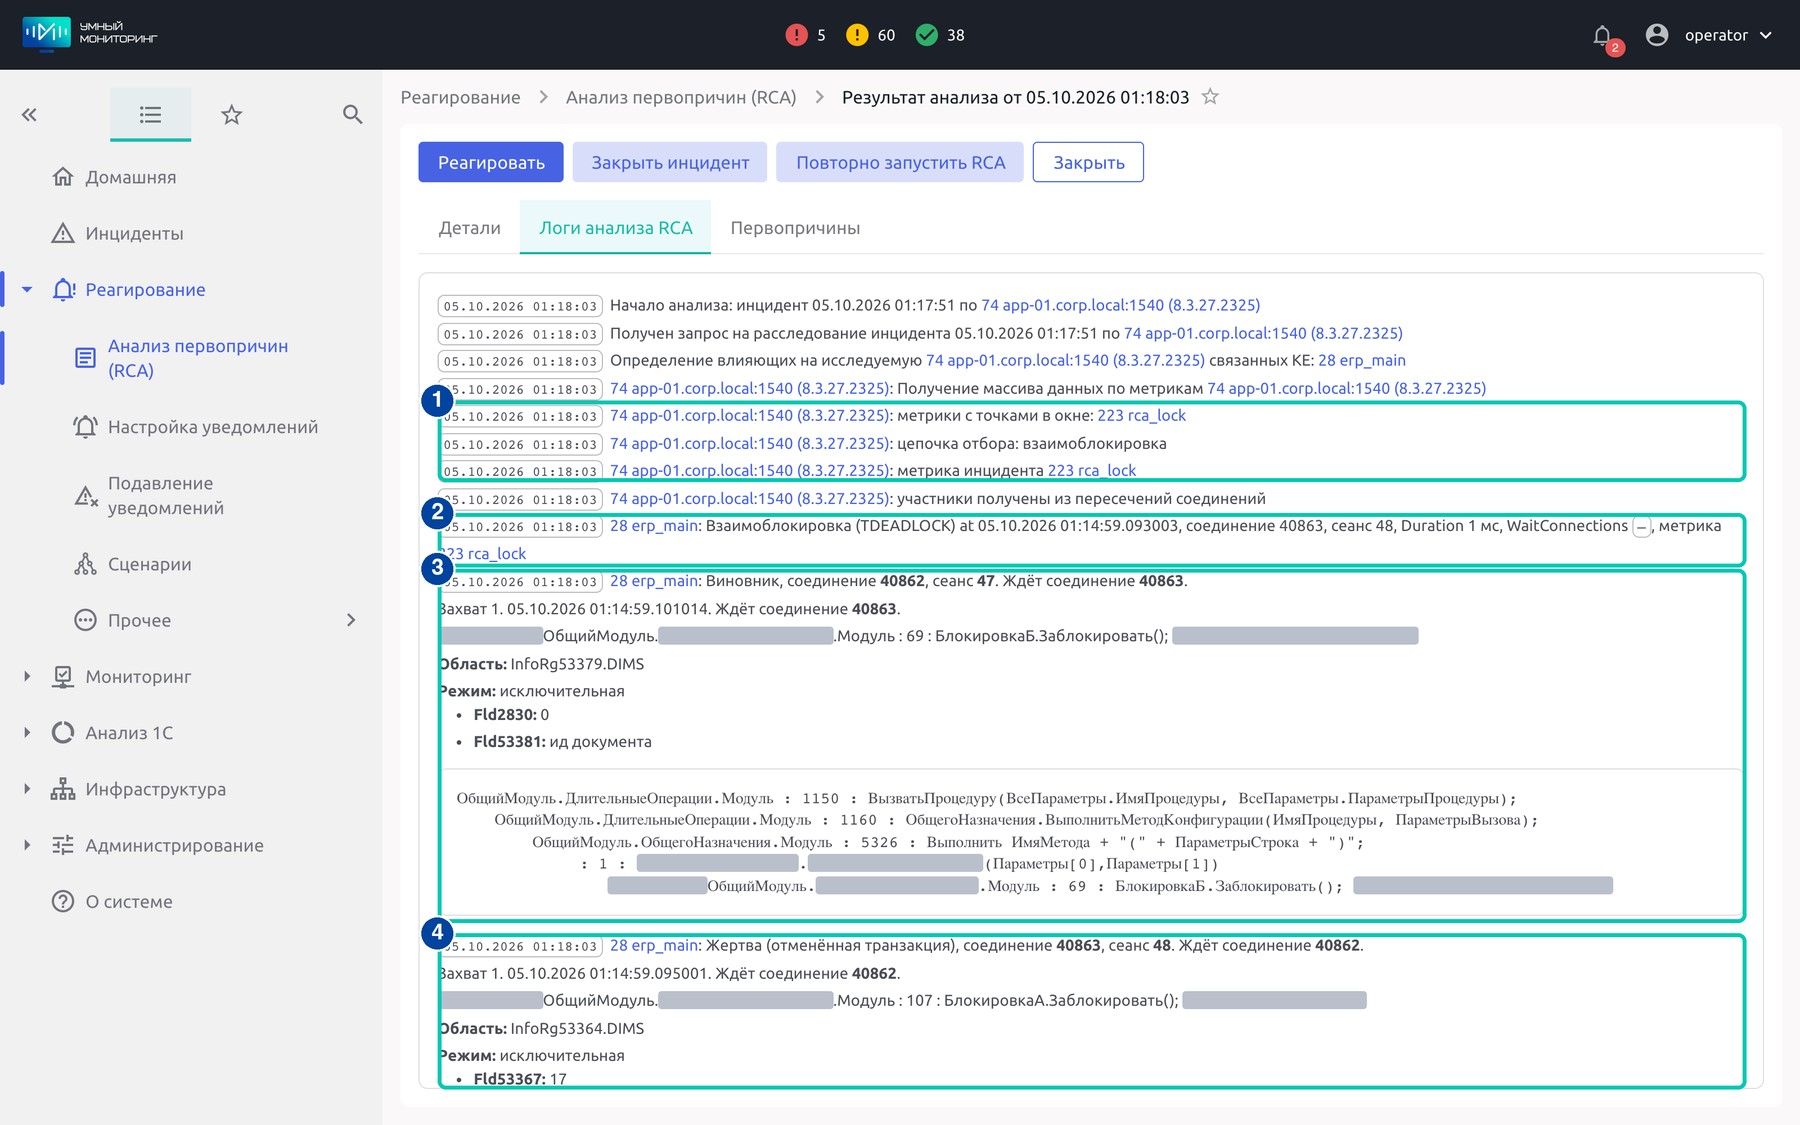
Рис. 3. Логи анализа RCA по взаимоблокировке. ①
Отбор по метрике блокировок. ②
Событие TDEADLOCK: жертва 40863. ③
Виновник 40862: строка 69, InfoRg53379. ④ Жертва 40863: строка 107, InfoRg53364.
Шаг 4. Проверка в «Анализе ТЖ»
Вывод RCA можно проверить вручную в разделе «Анализ 1С → Анализ технологического журнала». Для этого нужно выбрать период инцидента и шаблон «Подробный анализ взаимоблокировок». В результате видны участники, области блокировок и порядок захвата ресурсов.
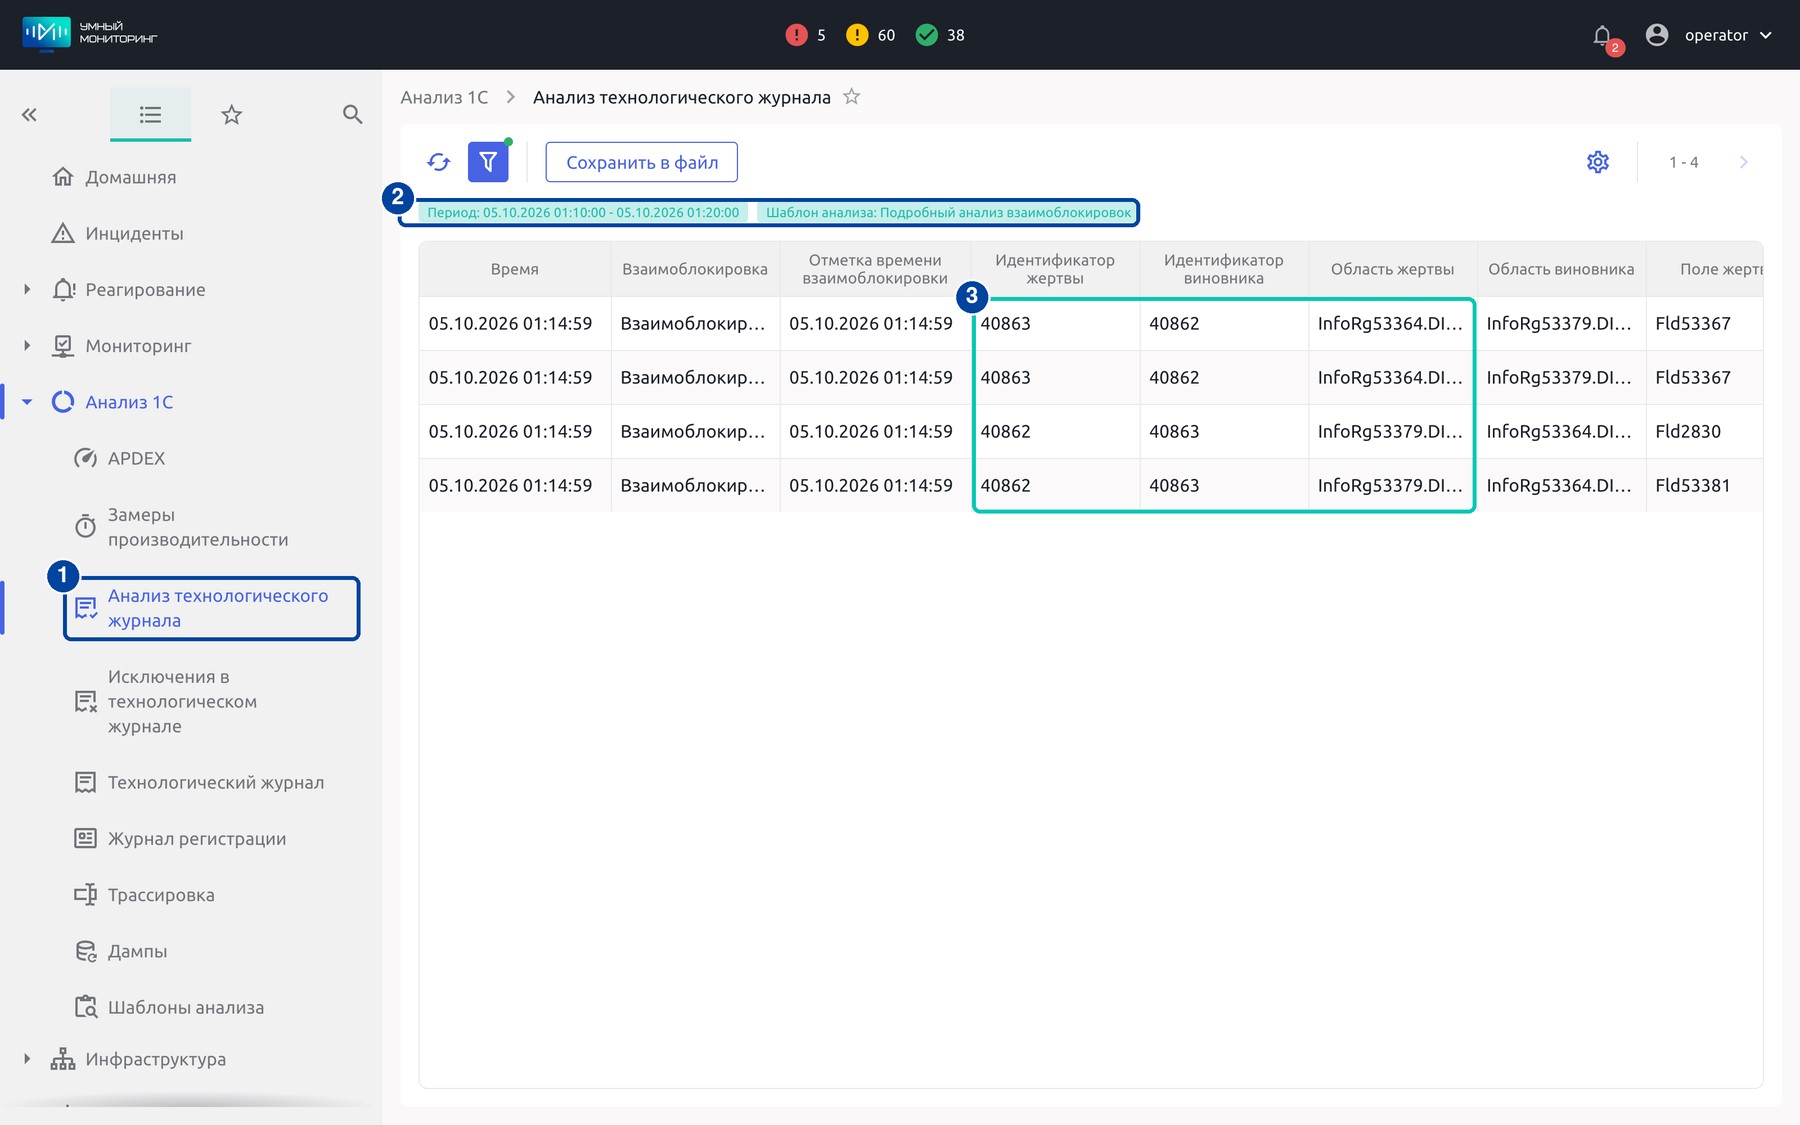
Рис. 4. Анализ ТЖ по шаблону «Подробный анализ взаимоблокировок». ① Анализ 1С →
Анализ технологического журнала. ② Период и шаблон взаимоблокировок. ③ Жертва, виновник, области.
Что проверить и исправить
Два фрагмента прикладного кода захватывают общие регистры в разном порядке. Чтобы избежать повторения взаимоблокировки, нужно установить единый порядок захвата ресурсов в транзакциях, которые работают с обоими регистрами.
Пример 2. Нагрузка на процессор: какой вызов её создал
Что случилось
В 00:47 на сервере 1С app-01 сработало правило «Нагрузка по CPU > 25% за последнюю минуту». Оно фиксирует превышение порога, но не объясняет, какой процесс или вызов создал нагрузку.
Шаг 1. Инцидент
Инцидент создан на КЕ «Сервер». После RCA в карточке появляется ИИ-рекомендация с данными об информационной базе, процессе rphost (PID 3104), сеансе и пользователе. Длительность найденного вызова – 9018 мс, из них 8384 мс – процессорное время. Такое соотношение указывает на вычисления в коде, а не на длительное ожидание СУБД или блокировок.
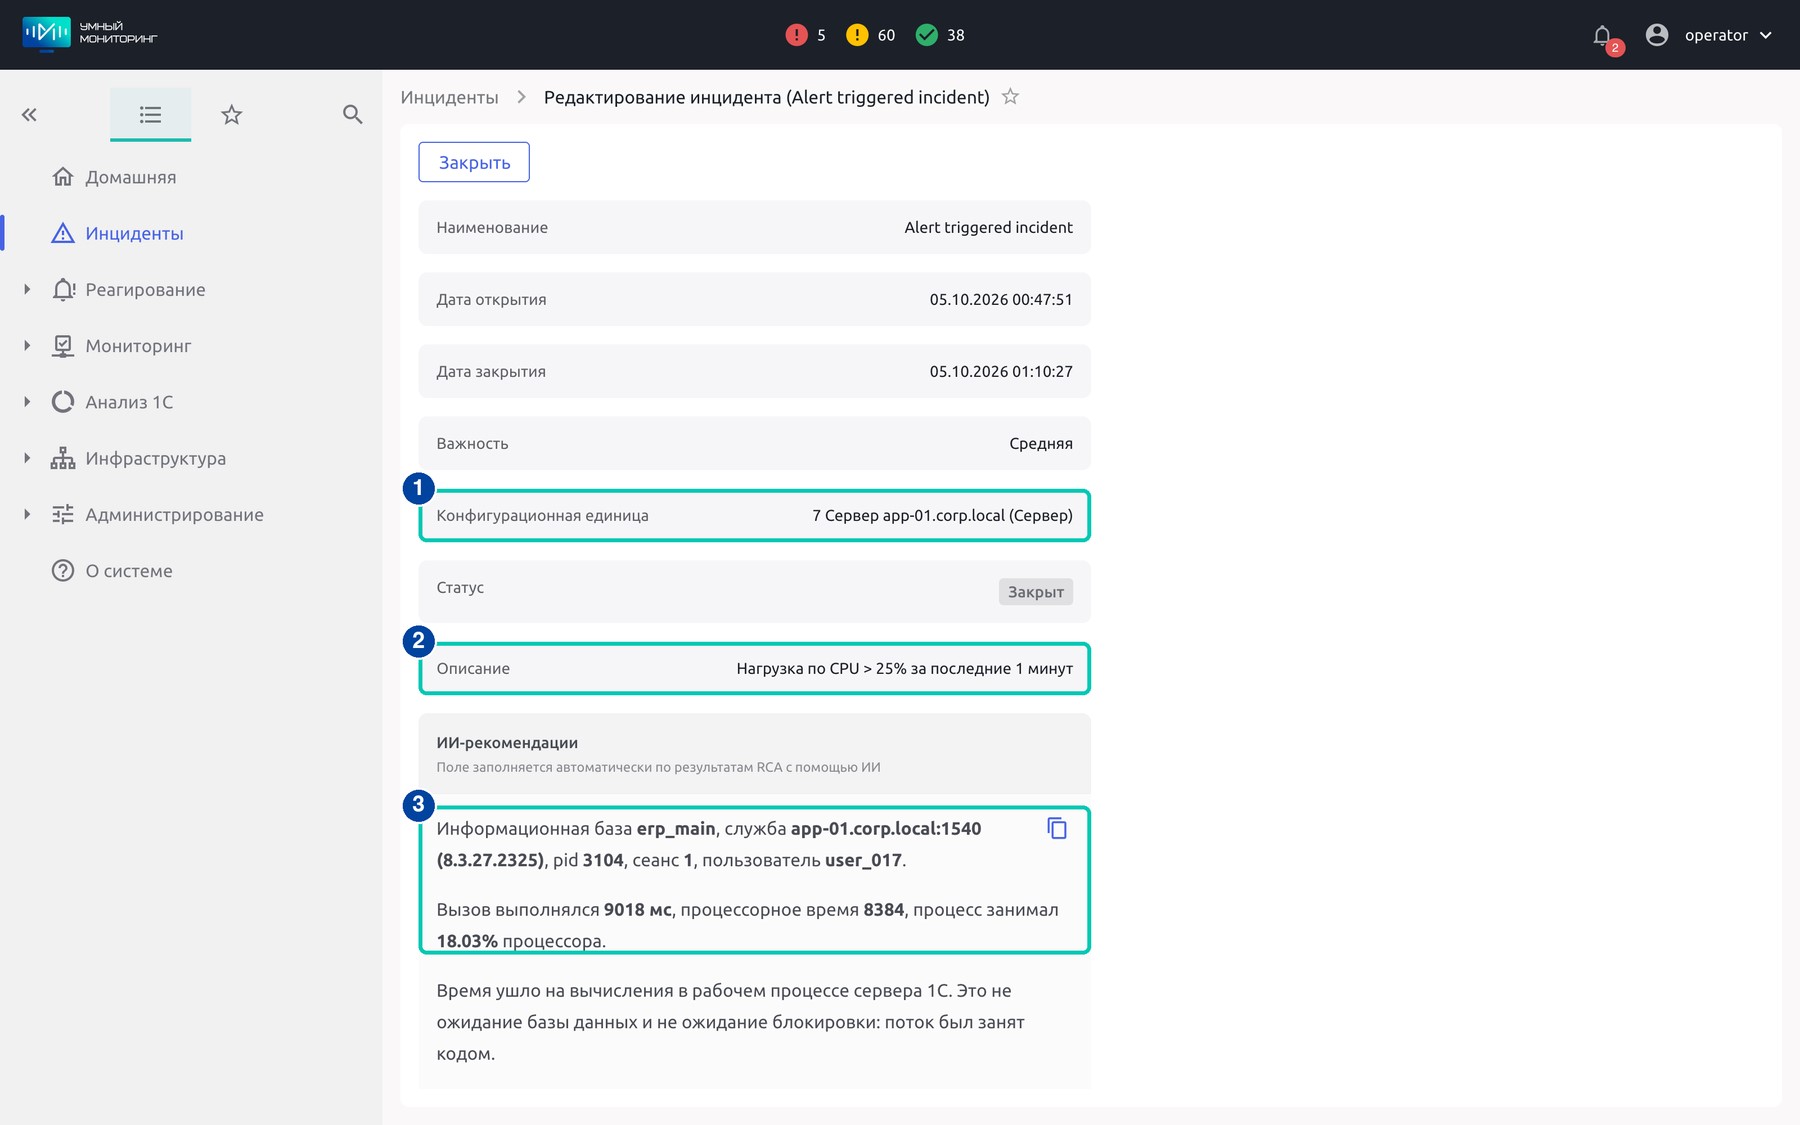
Рис. 5. Инцидент по нагрузке на процессор. ①
Сервер app-01. ②
CPU > 25% за минуту. ③
База, pid 3104, сеанс, пользователь, 9018 мс.
Шаг 2. Логи анализа
Сначала RCA определил процесс ОС с заметной нагрузкой – rphost, PID 3104. Затем выбрал его серверные вызовы 1С за период инцидента, исключив служебные события кластера и вызовы, начавшиеся позже. Остался один CALL с пользователем, длительностью, процессорным временем и стеком до метода формы. В поле «Первопричина» указана база erp_main. Порог алерта 25% относится к серверу, а показатель 18% в логах – к отдельному процессу rphost.
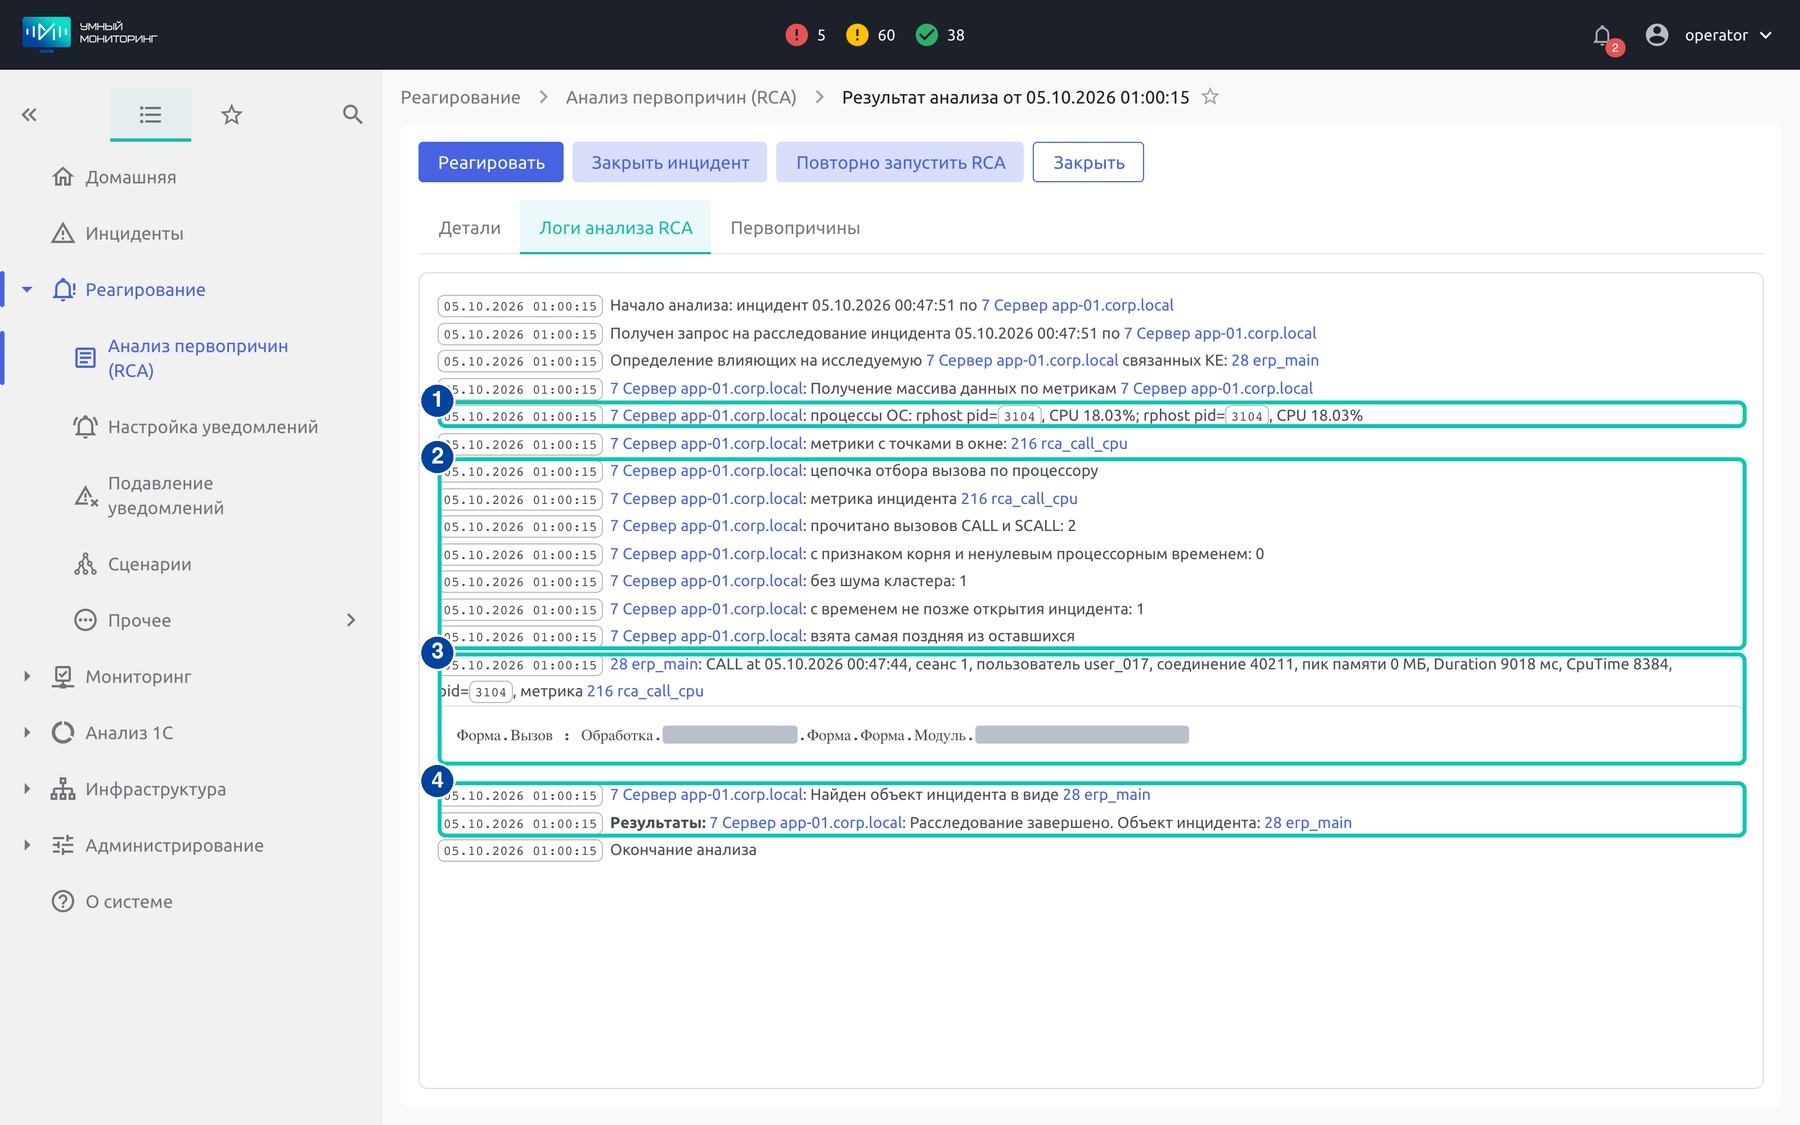
Рис. 6. Логи анализа RCA по нагрузке на процессор. ①
Процесс ОС rphost pid 3104: 18% CPU. ② Отбор вызовов по процессорному времени. ③ Найден CALL: 9018 мс, CpuTime 8384. ④ Первопричина: база erp_main.
Шаг 3. Проверка в технологическом журнале
В разделе «Технологический журнал» с детализацией «Сырые данные» за несколько секунд до инцидента виден тот же вызов CALL в базе erp_main: 9 секунд выполнения, из них 8,4 секунды процессорного времени.
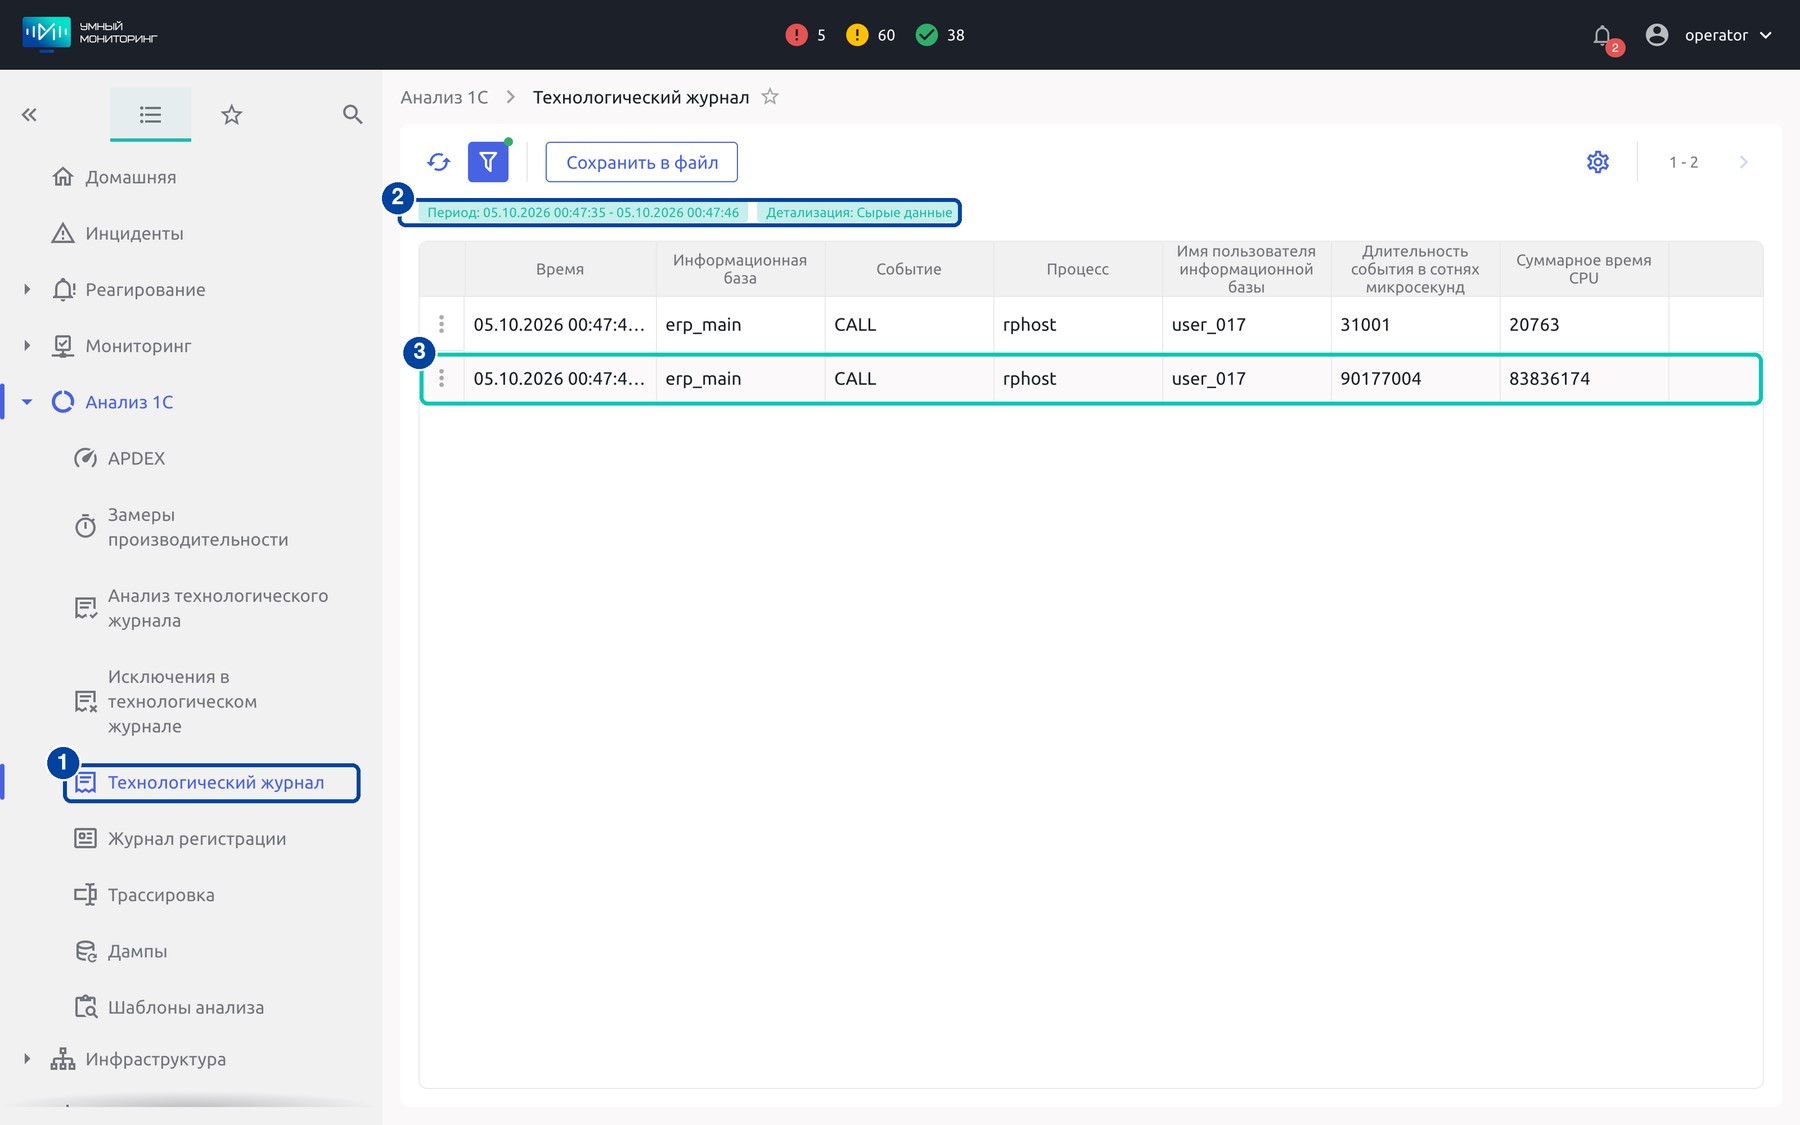
Рис. 7. Технологический журнал за окно инцидента. ①
Анализ 1С → Технологический журнал. ② Период 00:47:35–00:47:46, RAW. ③ CALL: 9 с, CPU 8,4 с.
Что проверить и исправить
Метод выполняет ресурсоёмкие вычисления на сервере в интерактивном вызове. Возможные решения – перенести обработку в фоновое задание или оптимизировать алгоритм. Порог оповещения по CPU стоит настроить с учётом обычной нагрузки на сервер.
Пример 3. Падение рабочего процесса и дамп
Что случилось
В 01:36 серверный вызов в базе erp_main потребовал почти 8 ГБ памяти. Через 13 минут, в 01:49, рабочий процесс rphost аварийно завершился, и сеансы пользователей на нём оборвались. До 01:59 произошло ещё три падения.
Шаг 1. Пик памяти в ТЖ
Для события CALL в технологическом журнале фиксируется пиковое потребление памяти за время вызова. В 01:36:24 оно достигло 7 971 718 282 байт (около 7,97 ГБ). Правило «Пик памяти серверного вызова» создаёт инцидент и запускает RCA, который помогает найти сеанс, пользователя и метод.
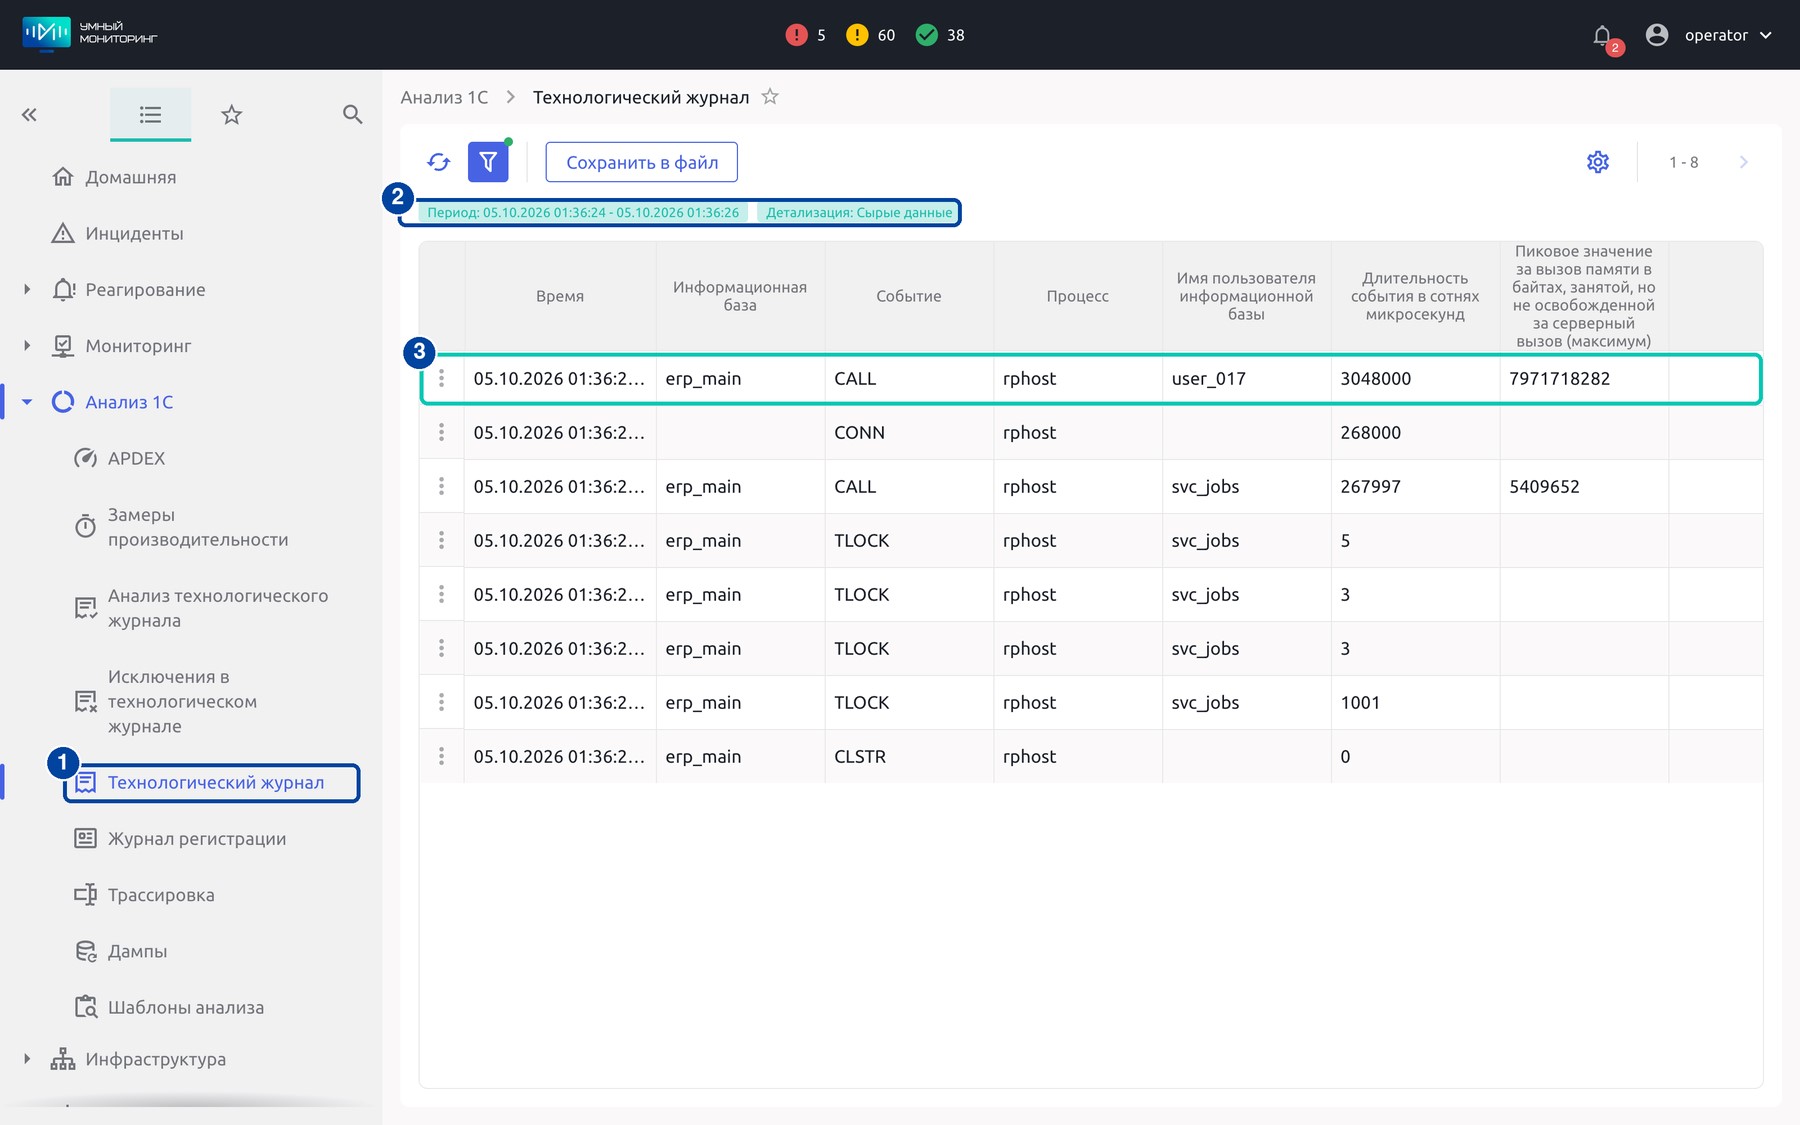
Рис. 8. Вызов с пиком памяти в технологическом журнале. ① Анализ 1С →
Технологический журнал. ②
Период 01:36:24–01:36:26, RAW. ③
CALL с пиком памяти 7,97 ГБ.
Шаг 2. Дампы
Раздел «Анализ 1С → Дампы» собирает core-файлы аварийно завершившихся процессов и автоматически разбирает их. В выбранном периоде с 01:00 до 02:30 видны четыре дампа rphost, созданные в течение десяти минут.
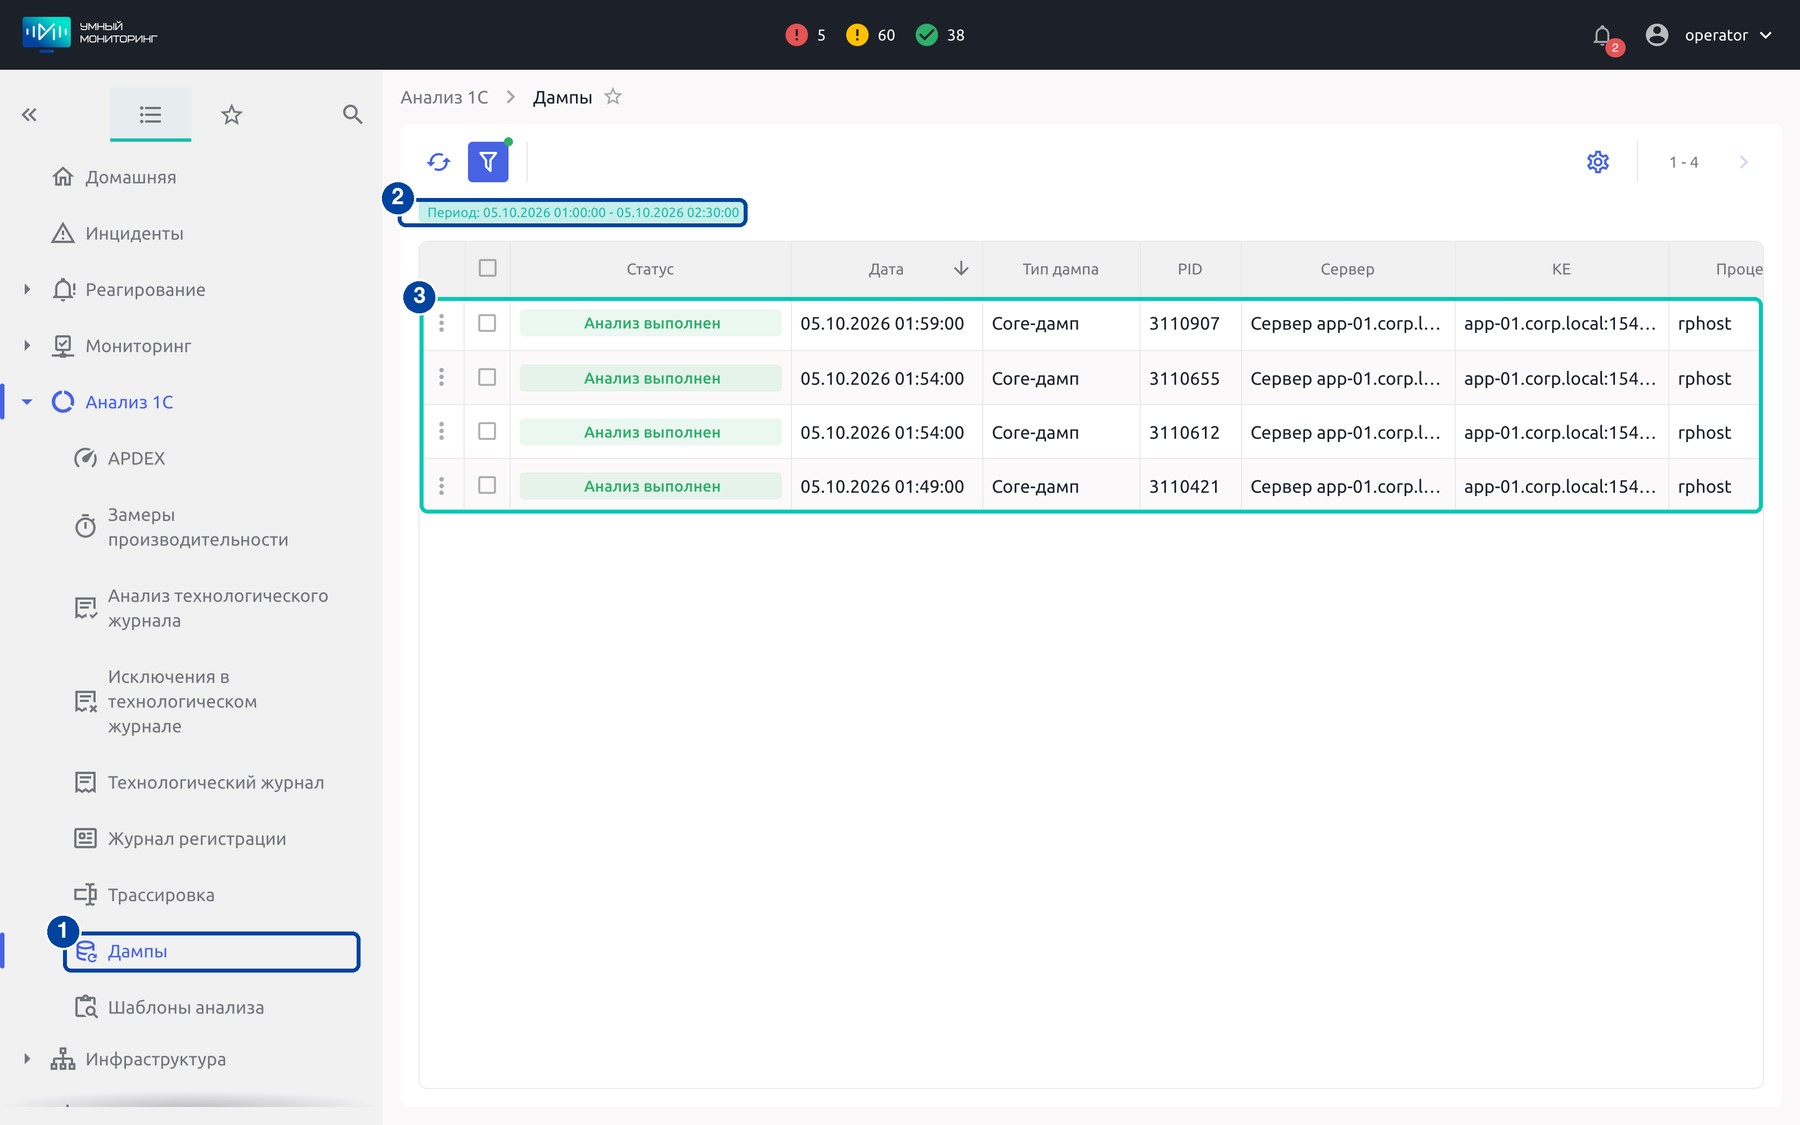
Рис. 9. Список дампов за ночь 5 октября. ①
Анализ 1С → Дампы. ② Период 05.10 01:00–02:30. ③ Четыре core-дампа rphost за 10 минут.
Шаг 3. Карточка дампа
В карточке указано, что rphost завершился по сигналу SIGABRT. Показаны сведения об аварийном потоке; модуль не определён. По одному этому признаку нельзя установить причину падения. С учётом более раннего пика памяти специалисту стоит проверить возможную связь событий.
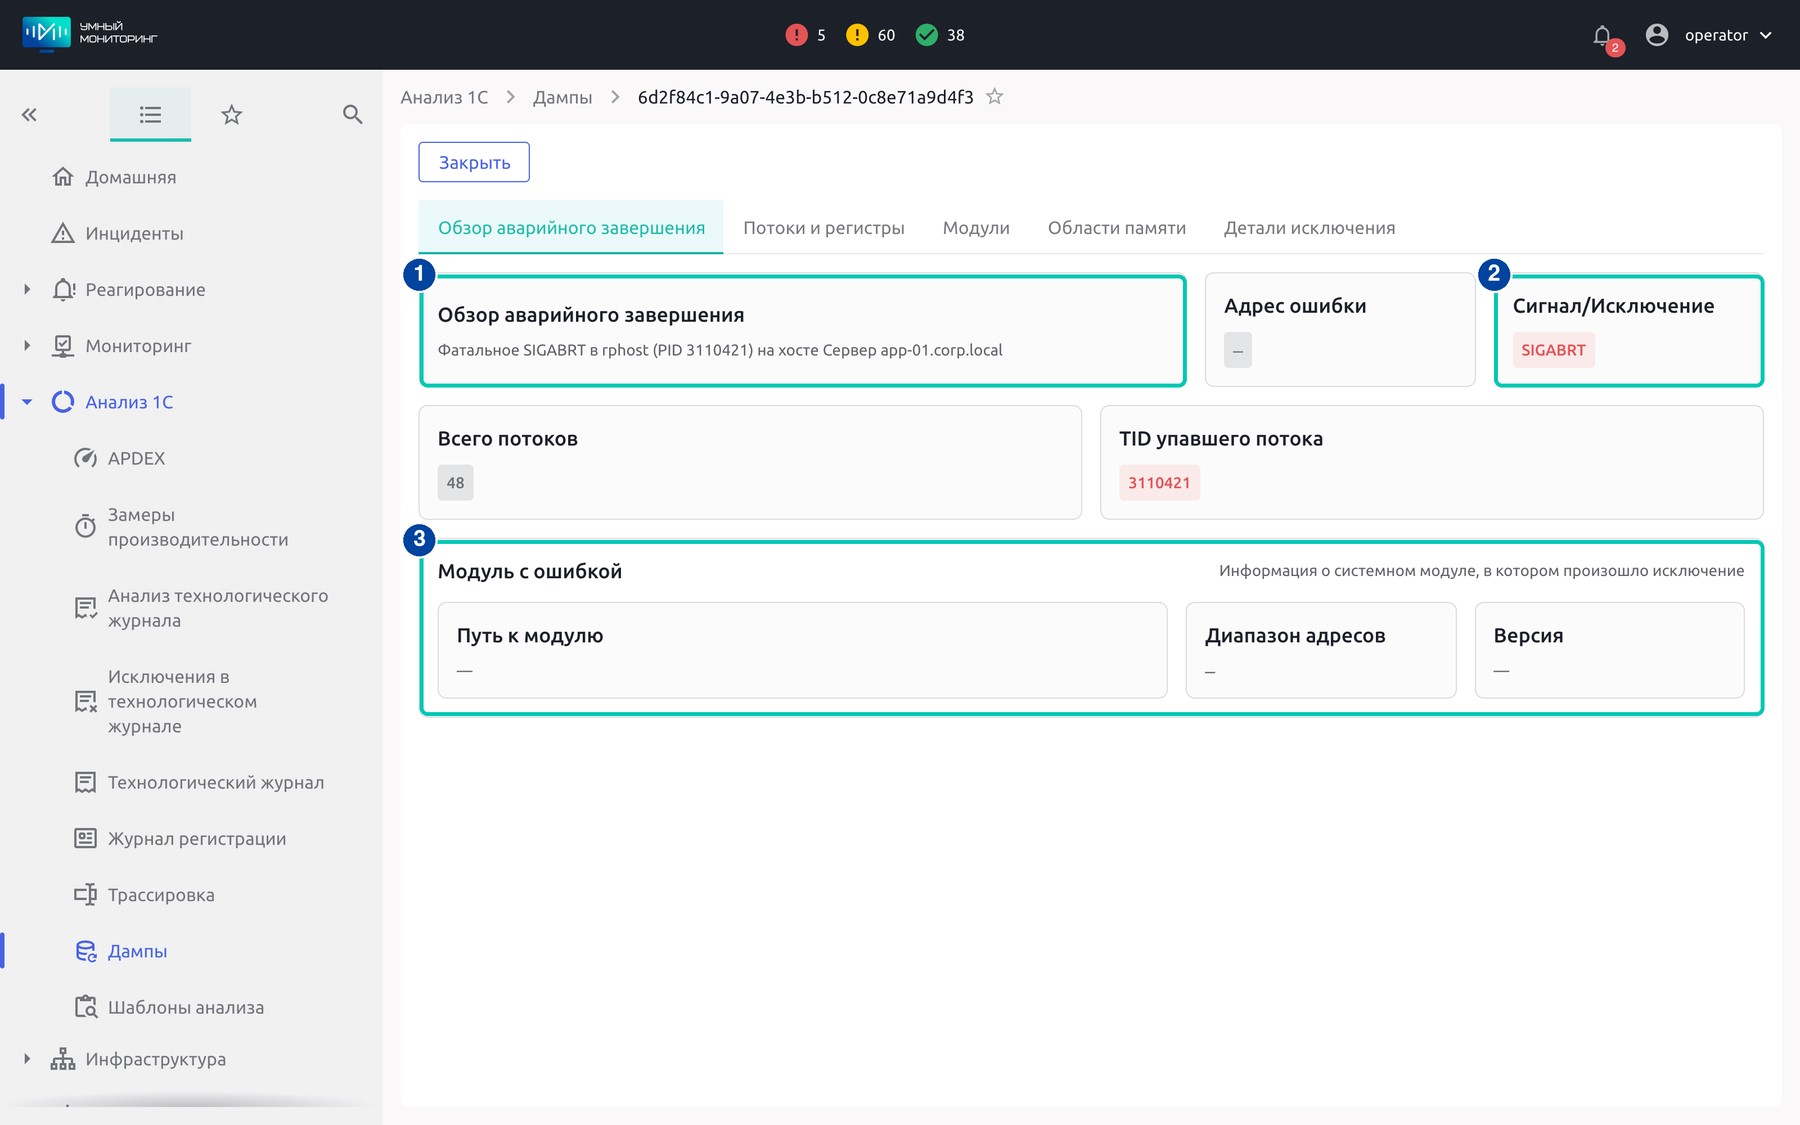
Рис. 10. Карточка разбора дампа. ①
Фатальное SIGABRT в rphost. ②
Сигнал. ③
Модуль не определён.
Шаг 4. Инцидент и логи анализа
При появлении дампа создаётся инцидент «Зафиксирован новый дамп процесса». RCA сопоставляет его с записью о падении: идентификатором процесса (PID), временем, путём к core-файлу, сигналом и ссылкой на карточку разбора.
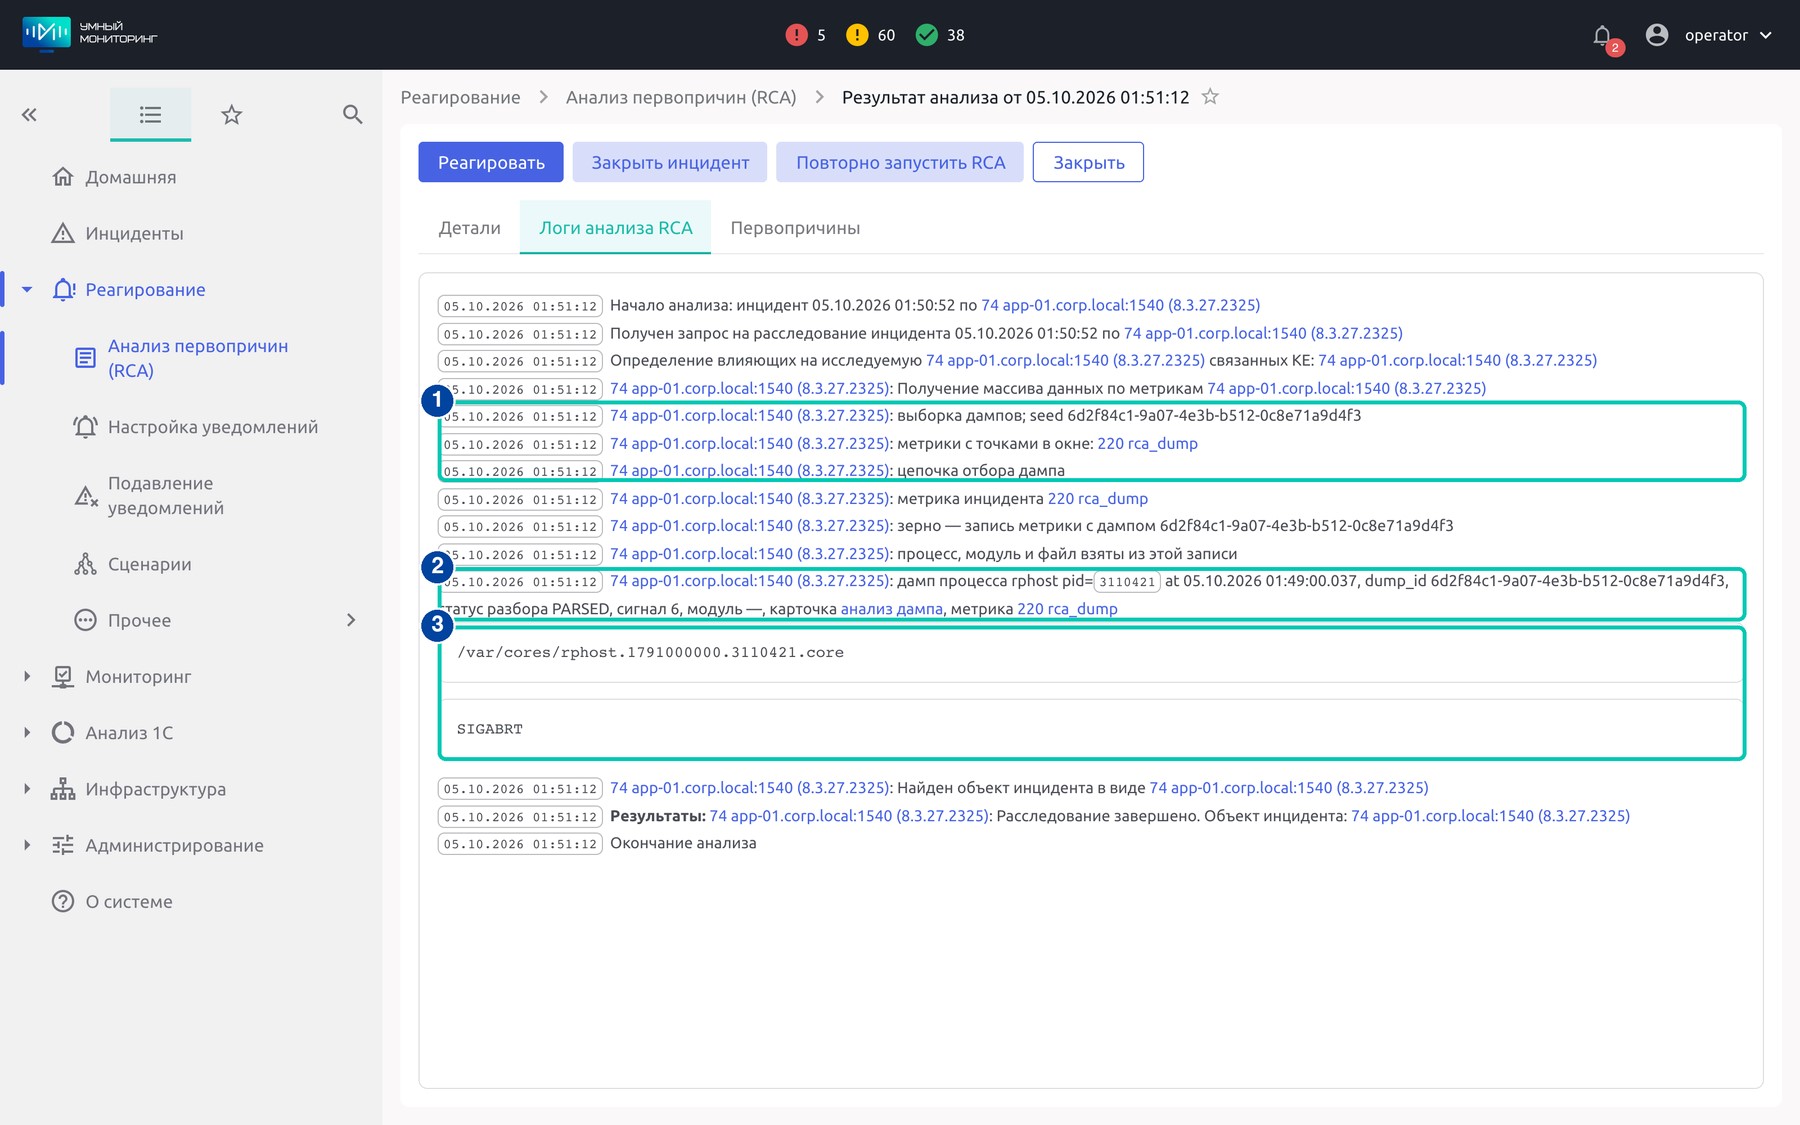
Рис. 11. Логи анализа RCA по дампу. ①
Выборка дампов в окне инцидента. ② rphost pid 3110421, 01:49:00, сигнал 6. ③ Путь к core-файлу и SIGABRT.
Что проверить и исправить
По стеку вызова, связанному с пиком памяти, нужно проверить операции, выделяющие большие объёмы памяти. Один из возможных источников – выгрузка всего результата запроса в таблицу значений. Если причина в этом, поможет выборка и обработка данных порциями. Дополнительно можно ограничить расход памяти на вызов в кластере. Это снижает риск повторных падений, но не заменяет исправление кода.
Совпадение пика памяти и падений по времени ещё не доказывает причинно-следственную связь. RCA помогает сформировать гипотезу, а специалист проверяет её по данным расследования и решает, что исправлять.
Цепочка анализа: от сервера к сеансу и коду
В основе трёх примеров – анализ связанных объектов и данных за период инцидента. Сервер, служба 1С, кластер и информационная база образуют граф зависимостей. RCA проходит по этим связям и сопоставляет инфраструктурные метрики с процессами ОС, вызовами 1С, событиями блокировок и дампами. Для такой детализации нужны агенты на серверах 1С и записи технологического журнала с контекстом выполнения: TDEADLOCK, TLOCK, CALL с данными о процессорном времени и пике памяти.
На демонстрационном стенде, специально настроенном на выполнение проблемных сценариев – за пять недель система «Умный мониторинг» зарегистрировала 331 инцидент и выполнила 343 анализа первопричин.
Что добавила версия 1.6
Метрики из данных мониторинга и внешних файлов
В версии 1.6 появился универсальный процессор формирования метрик. Он преобразует записи из таблиц «Умного мониторинга» и загруженные данные, в том числе журналы в форматах JSON и CSV, в показатели для дальнейшего анализа.
RCA теперь может учитывать не только загрузку процессора, потребление памяти и состояние дисков, но и длительность операций, события ТЖ, показатели производительности 1С, включая APDEX, а также метрики, настроенные под задачи заказчика.
Например, можно рассчитывать показатель по выбранным событиям ТЖ или отслеживать изменение потребления памяти между измерениями. Это помогает расследовать инциденты, которые трудно объяснить только стандартными метриками сервера.
Сценарии RCA с учётом особенностей системы заказчика
В поставку входят готовые шаблоны RCA для распространённых проблем 1С. Если нужна своя последовательность проверок, можно добавить сценарий со скриптом и шаблоном представления результата. Для этого не требуется переустанавливать продукт.
В корпоративных системах это особенно полезно: конфигурации, доработки и интеграции различаются у разных заказчиков. Поставочные правила дают основу для диагностики, а дополнительные метрики и сценарии позволяют учитывать особенности конкретной системы.
Что меняется в работе команды сопровождения
При ручном расследовании специалист сопоставляет сигналы мониторинга, процессы, сеансы и события ТЖ. Зачастую это отнимает ощутимое время – столь ценное, когда нужно срочно устранить возникший инцидент. «Умный мониторинг» выполняет значительную часть этой работы автоматически, после регистрации инцидента – причем, очень быстро.
Вместо отдельного сигнала о проблеме команда сразу получает данные для общей диагностики и решения проблемы:
- условие срабатывания алерта
- связанные объекты и метрики за период инцидента
- контекст 1С: базу, процесс, сеанс, пользователя и вызов
- результат RCA по готовому или настроенному сценарию
RCA не исправляет прикладной код и не заменяет эксперта. Он сопоставляет факты и существенно сокращает ручной поиск, чтобы команда быстрее перешла от симптома к проверяемой гипотезе. Проверить её, а затем изменить запрос, логику блокировок или прикладной код должны специалисты сопровождения и разработки.
От наблюдения к расследованию
Для сопровождения корпоративной 1С недостаточно отслеживать загрузку серверов. Важно видеть, как состояние инфраструктуры связано с работой приложения. «Умный мониторинг» помогает проследить эту связь: RCA анализирует связанные метрики и показывает технический контекст вплоть до сеанса, вызова и, при наличии данных, строки кода. Это даёт специалистам больше оснований для проверки гипотез и сокращает объём ручного поиска.
Вебинар 11.11
На вебинаре 11 ноября покажем расследование инцидентов 1С на демонстрационном стенде: от срабатывания правила до результатов RCA. Разберём настройку ТЖ 1С и правил, ответим на вопросы.
Зарегистрируйтесь сейчас, чтобы не пропустить мероприятие, а после - получить видеозапись и дополнительные материалы.
ЗАРЕГИСТРИРОВАТЬСЯ
Подробнее: возможности «Умного мониторинга» и обзор релиза 1.6.
Подписывайтесь на наши каналы в Telegram и MAX